Sobre a vaga
Por trás de cada resposta da Jurid IA existe uma pergunta difícil: o modelo encontrou o trecho certo? Citou a fonte correta? A busca entendeu o que o advogado queria dizer? Essas perguntas se respondem com dados bem cuidados e com métricas honestas.
Nesta vaga você vai cuidar da saúde dos nossos bancos de dados, desenhar pipelines de ingestão de documentos jurídicos, ajustar a busca semântica e construir avaliações que nos digam, com números, se uma mudança deixou o produto melhor ou pior.
É uma posição com um pé na engenharia de dados e outro na ciência de dados aplicada a modelos de linguagem. Perfeita para quem gosta de olhar uma consulta lenta e uma curva de precisão com o mesmo entusiasmo.
O que você vai fazer
- Modelar, otimizar e monitorar bancos PostgreSQL em produção (índices, particionamento, consultas).
- Construir pipelines de ingestão, limpeza e chunking de documentos jurídicos.
- Operar e ajustar bases vetoriais (Qdrant) e estratégias de busca híbrida.
- Criar conjuntos de avaliação e métricas para respostas de IA (relevância, citação, alucinação).
- Montar dashboards de uso do produto que ajudem o time a decidir.
O que buscamos
- SQL avançado e experiência real administrando ou otimizando bancos relacionais.
- Python para análise e manipulação de dados.
- Conhecimento de estatística aplicada e de como desenhar uma boa métrica.
- Noções de embeddings, busca vetorial e RAG.
“Procuramos pessoas que levem o problema do advogado tão a sério quanto a tecnologia.”
Fundadores da Jurid IA
Diferenciais
- Experiência com avaliação de LLMs (evals) ou anotação de dados.
- Familiaridade com dados públicos do Judiciário brasileiro.
- Experiência com cuidados de privacidade e LGPD em dados sensíveis.
Como é o dia a dia
Parte do tempo é engenharia: investigar uma consulta que ficou lenta, ajustar um índice, revisar um pipeline. Outra parte é ciência: rodar uma avaliação depois de trocar o modelo de embeddings e apresentar ao squad o que mudou. Tudo documentado, versionado e discutido por escrito.
Onde seu trabalho aparece
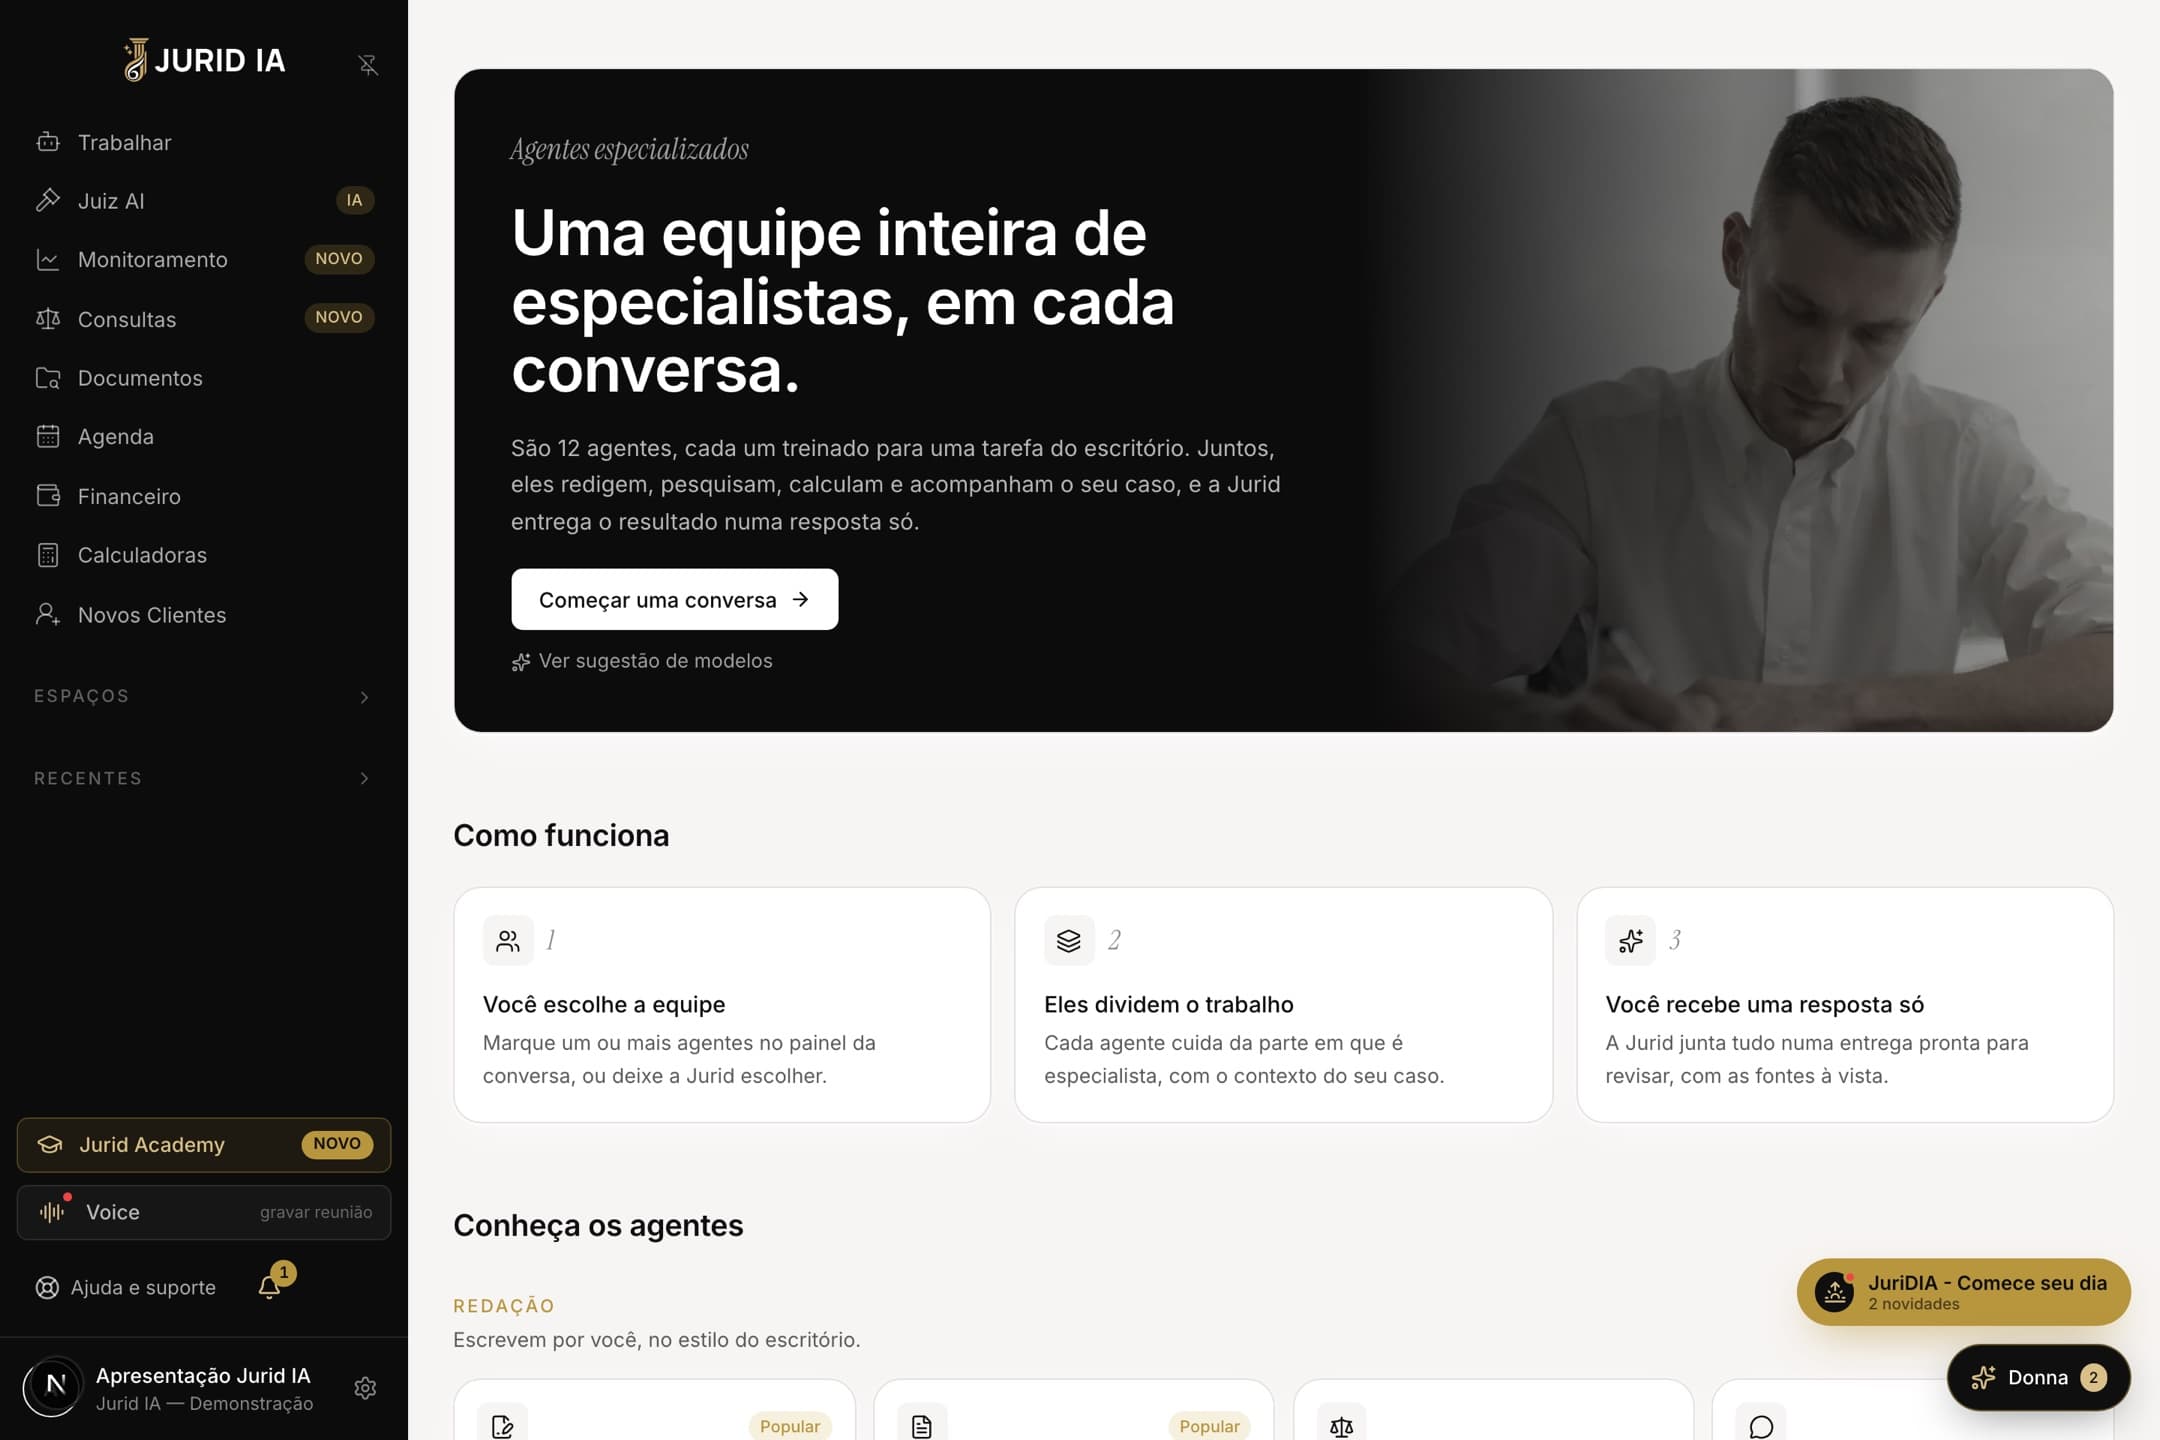
Stack e ferramentas
- PostgreSQL
- Qdrant
- Python
- SQL
- TypeScript (integração)
- Docker
- AWS
- Notebooks e dashboards
Processo seletivo
- 01
Candidatura
Mande currículo ou LinkedIn e algumas linhas sobre por que essa vaga faz sentido para você. Portfólio, GitHub ou cases ajudam bastante.
- 02
Conversa inicial
Um bate-papo de cerca de 30 minutos para entender sua trajetória, o que você procura e tirar dúvidas sobre a Jurid IA.
- 03
Desafio prático
Um caso com um pequeno conjunto de dados: você propõe uma modelagem ou uma métrica de avaliação e apresenta suas conclusões.
- 04
Conversa com os fundadores
Encontro com João Stel e Gabriel Antônio (e, quando fizer sentido, Dr. Pedro Savordelli) para falar de cultura, expectativas e próximos passos.
- 05
Retorno
Respondemos todas as pessoas que chegam às etapas de conversa, com ou sem aprovação.
Perguntas frequentes
A vaga é mais de DBA ou de ciência de dados?
É híbrida. Precisamos de alguém confortável com banco em produção e com análise e avaliação de IA. Conte na candidatura onde você é mais forte.
Vou trabalhar com dados de clientes?
Sempre com regras de acesso e cuidados de privacidade. Boa parte das avaliações usa dados públicos ou anonimizados.
Preciso entender de Direito para trabalhar na Jurid IA?
Não. Curiosidade pelo dia a dia do advogado ajuda muito, mas o contexto jurídico se aprende aqui, com o time e com os próprios clientes.
Por que a vaga não informa remuneração?
Preferimos conversar sobre isso diretamente, considerando experiência, formato de contratação e momento da empresa. O tema entra já nas primeiras conversas.